[PostgreSQL] 부분 인덱스란?
부분 인덱스의 개념과 JPA에서 부분 인덱스가 사용되지 않는 이유 알아보기
부분 인덱스란
부분 인덱스는 테이블 전체가 아니라, 지정한 조건을 만족하는 행만 담는 인덱스다.
가상의 쇼핑몰 관리 페이지를 예로 들어보자. 주문 테이블에는 배송이 끝난 주문도 계속 쌓이지만, 관리자가 주로 조회하는 것은 오래된 배송 대기 주문이다. 이 조회를 위해 전체 주문을 인덱스에 담아야 할까?
부분 인덱스를 사용하면, status 가 'READY_TO_SHIP'인 주문만 담고, 그 주문을 created_at 순으로 정렬할 수 있다.
1
2
3
CREATE INDEX idx_orders_ready_to_ship
ON orders (created_at)
WHERE status = 'READY_TO_SHIP';
MySQL에는 PostgreSQL처럼
CREATE INDEX … WHERE …로 일부 행만 담는 부분 인덱스가 없다. 대신 이 예시의 상태 조건과 생성 시간순 조회에는(status, created_at)복합 인덱스를 고려할 수 있다.
❓ 복합 인덱스보다 무조건 빠를까?
아니다.
복합 인덱스에 모든 주문이 들어 있어도, 배송 대기 주문을 조회할 때 다른 상태의 주문까지 훑지 않는다.
WHERE status = 'READY_TO_SHIP' ORDER BY created_at ASC LIMIT 20; 을 예로 들어보자.
- 부분 인덱스: 배송 대기 주문만 담고 있으며, 인덱스가
created_at순서를 유지한다. 따라서 앞에서부터 읽으면 오래된 주문부터 나온다. - 복합 인덱스
(status, created_at): 첫 번째 컬럼인status가 고정되어 있으므로, 배송 대기 주문 구간의 시작점으로 바로 이동할 수 있다. 그 구간 안에서는 이미created_at을 기준으로 오름차순 정렬되어 있다.
PostgreSQL이 인덱스 순서를 활용하는 실행 계획을 선택하면, 두 인덱스 모두 별도 정렬 없이 필요한 20건을 조회하고 멈출 수 있다. 따라서 부분 인덱스가 무조건 더 빠르다고 할 수는 없다.
이러한 조회에서 부분 인덱스의 장점은 다른 상태의 주문을 스캔하지 않는 데 있다기보다, 배송 대기 주문만 담아 인덱스를 작게 유지할 수 있다는 점이다. 따라서 배송 대기 주문이 전체에서 차지하는 비율이 작을 때 유리할 수 있다. 반면 다른 상태의 주문을 조회해야 할 때는 해당 인덱스를 사용할 수 없다는 점도 기억해두어야 한다.
부분 인덱스는 조건에 맞지 않는 행을 담지 않으므로, 인덱스 크기와 일부 쓰기 비용을 줄일 수 있다.
⚠️ JPA 사용 시 주의할 점
다만 부분 인덱스를 만들어두었다고 해서 모든 조회에서 사용할 수 있는 것은 아니다.
JPA를 사용한다면 생성된 SQL에서 조건이 어떻게 표현되는지 확인해야 한다.
예를 들어, 다음 메서드를 호출한다고 해보자.
1
findByStatus(READY_TO_SHIP);
Spring Data JPA가 메서드 이름으로 쿼리를 만들 때, 인자로 받은 상태 값은 SQL에 직접 넣지 않고 파라미터로 바인딩한다. PostgreSQL에는 WHERE status = $1 형태의 SQL과 READY_TO_SHIP이라는 값이 따로 전달된다.
부분 인덱스를 사용하려면, PostgreSQL이 조회하려는 행이 모두 해당 인덱스에 들어 있다고 판단할 수 있어야 한다. 그런데 상태가 WHERE status = $1처럼 파라미터로 전달되면, 실행 계획을 만들 때 그 값을 참고하는지에 따라 부분 인덱스의 사용 가능 여부가 달라진다.
전달된 값을 반영하여 만드는 custom plan은 READY_TO_SHIP이 전달된 경우 부분 인덱스를 후보로 고려할 수 있다. 반면 특정 값에 의존하지 않고 재사용하는 generic plan은 $1에 다른 상태가 들어와도 사용할 수 있어야 하므로, 배송 대기 주문만 담은 부분 인덱스를 사용할 수 없다.
배송 대기 주문만 조회하는 메서드라면, JPQL에서 상태를 인자로 받는 대신 enum 리터럴로 지정할 수 있다. 실제 테스트에서는 다음과 같이 작성했다.
1
2
3
4
5
6
@Query("""
    select o.id from Order o
    where o.status = lab.partialindex.OrderStatus.READY_TO_SHIP
    order by o.createdAt
    """)
List<Long> findReadyToShipIds(Limit limit);
이처럼 JPQL에서 상태를 지정하면 고정된 값을 반영한 SQL이 생성되고, generic plan에서도 부분 인덱스를 후보로 고려할 수 있다. 다만 실제로 선택되는지는 실행 계획에서 확인해야 한다.
🧪 JPA 테스트 해보기
상태를 파라미터로 전달할 때와 JPQL enum 리터럴로 고정할 때 생성되는 SQL이 어떻게 달라지는지, 그 차이가 generic plan의 부분 인덱스 선택에 영향을 주는지 확인해 보았다.
테스트는 로컬 PostgreSQL에서 가상의 주문 60,000건(배송 대기 60건)을 넣고, 두 방식으로 같은 배송 대기 주문 20건을 조회하는 것으로 구성했다.
1️⃣ Hibernate로 생성된 SQL 확인하기
상태를 인자로 받는 메서드(A)와 JPQL에 enum 리터럴을 지정한 메서드(B)를 각각 실행했다. 두 메서드가 동일한 주문 ID 20개를 같은 순서로 반환하는지 먼저 검증했다. 이후 Hibernate 로그에서 각 메서드가 생성한 SQL과 바인딩 값을 확인했다.
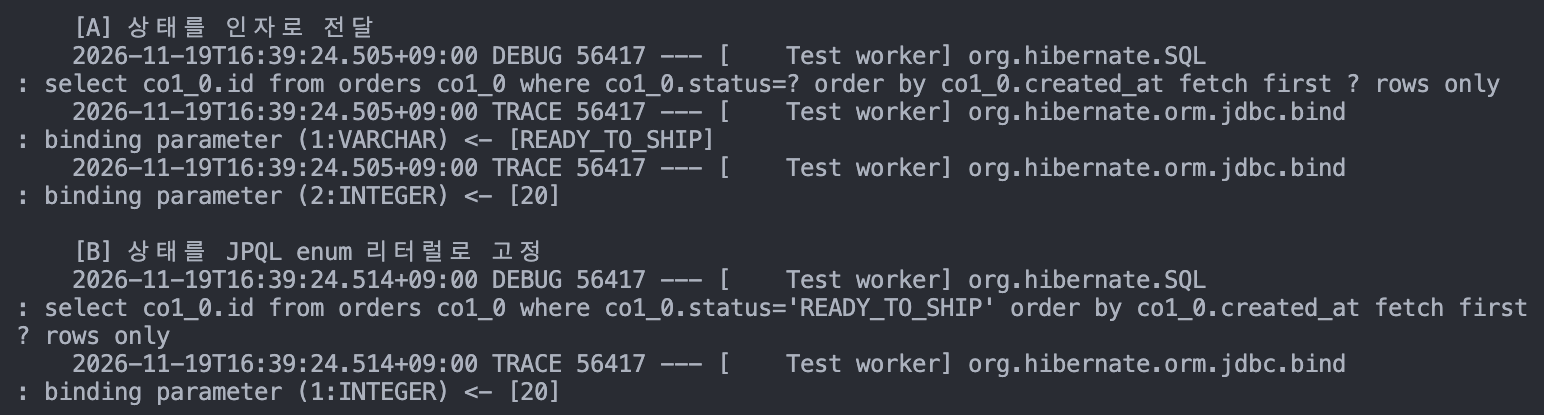 Hibernate SQL과 바인딩 로그: 상태를 인자로 받는 경우와 JPQL enum 리터럴로 값을 고정하는 방식 비교
A의 로그를 보면, SQL에 status = ?가 남고, 상태 READY_TO_SHIP과 조회 건수 20을 각각 바인딩한다. B는 status = 'READY_TO_SHIP'이 SQL에 들어가므로 20만 바인딩한다.
2️⃣ 실행 계획으로 어떤 인덱스를 선택하는지 확인하기
1단계에서 생성된 SQL을 실행 계획 비교에 재사용하기 위해 StatementInspector 로 SQL을 보관했다. 보관한 SQL의 ? 를 $1 , $2 로 바꾸고 EXPLAIN (GENERIC_PLAN) 을 붙여 PostgreSQL에 요청했다. 실제 JPA 조회가 사용한 계획을 수집한 것이 아니라, 생성된 SQL을 generic plan으로 만들었을 때의 계획을 별도로 비교한 것이다.
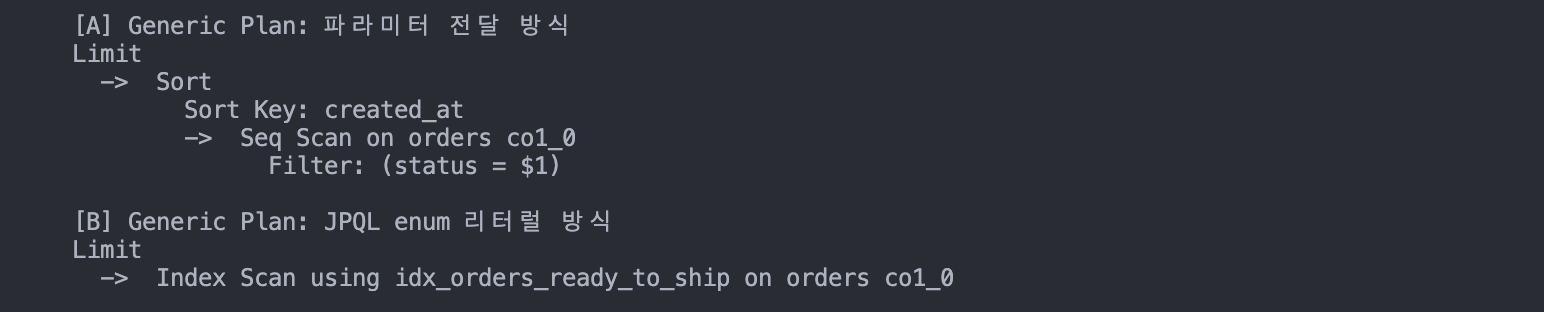 EXPLAIN (GENERIC_PLAN)으로 각 방식의 실행 계획 비교
- A의 SQL에서는 테이블 전체를 스캔한 뒤 정렬하는 계획이 나왔다.
- B의 SQL에서는 배송 대기 주문만 담은 부분 인덱스를 사용하는 계획이 나왔고, 별도 정렬 단계는 없었다.
Prepared statement에서 custom plan과 generic plan을 언제 만들고 어떤 기준으로 선택하는지는 후속 글에서 자세히 다룰 예정이다. (작성 후 링크 예정)
✅ 정리
- 부분 인덱스는 특정 조건에 해당하는 행만 인덱스로 관리하는 방법이다.
- 다만 인덱스를 만드는 것만으로 끝나는 것은 아니다. 조회 조건이 해당 인덱스를 사용할 수 있는 형태인지, 실제 실행 계획에서도 선택되는지 함께 확인해야 한다.